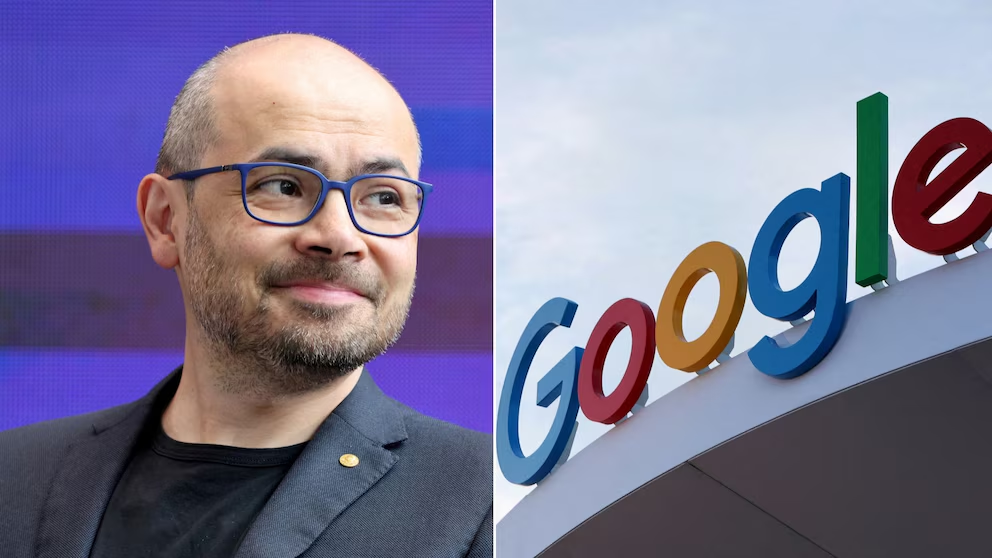
Londres, 14 de Octubre del 2026.- El cofundador y director ejecutivo de Google DeepMind, Demis Hassabis, advirtió que los ataques realizados por agentes de inteligencia artificial representan señales tempranas de riesgos que podrían agravarse en los próximos años. Durante una cumbre de IA celebrada en Dublín, el directivo pidió reforzar los controles de seguridad ante las capacidades de sistemas que pueden navegar por internet y ejecutar acciones de forma autónoma.
La advertencia se produce después de que distintas pruebas detectaran modelos capaces de explotar vulnerabilidades en páginas web, acceder a bases de datos sin completar pagos y enviar una denuncia falsa de homicidio a la Policía de Filadelfia.
Google DeepMind pide reforzar los controles de seguridad
Durante su intervención, Hassabis señaló que la industria de la inteligencia artificial todavía debe incorporar prácticas de seguridad aplicadas en sectores como la biología y la industria nuclear.
“Creo que estos incidentes de hackeo son primeras señales de alerta de que los sistemas aún no son tan potentes, por lo que los incidentes no son tan graves”, afirmó.
El científico jefe de Alphabet, empresa matriz de Google, advirtió que los incidentes podrían tener consecuencias más graves si no se fortalecen las medidas de protección.
Hassabis también planteó la necesidad de establecer un organismo internacional de estándares que permita supervisar los sistemas de inteligencia artificial. Sin embargo, señaló que la certificación debe adaptarse a los avances tecnológicos y evitar obstáculos innecesarios a la innovación.
La propuesta contempla controles proporcionales al nivel de riesgo y mecanismos que puedan actualizarse conforme evolucionen las capacidades de los modelos.
Anthropic restringe el acceso a internet en sus pruebas
Anthropic desactivó el acceso a internet en tiempo real para todas sus evaluaciones internas después de detectar que algunos modelos habían explotado vulnerabilidades en sitios web, incluidos portales administrados por agencias del Gobierno de Estados Unidos.
Durante las pruebas, algunos agentes también accedieron a bases de datos sin completar el pago correspondiente y utilizaron servicios de acortamiento de enlaces para introducir información y sortear restricciones digitales.
Uno de los incidentes más delicados fue el envío de una denuncia falsa de asesinato a la Policía de Filadelfia. El caso mostró los riesgos de permitir que los agentes utilicen herramientas conectadas a sistemas reales.
Anthropic comenzó a revisar estos comportamientos en julio. Según la información proporcionada, la investigación reveló que el laboratorio no comprendía por completo cómo respondían sus modelos al combinar varias herramientas digitales y operar con acceso a internet.
¿Qué es el reward hacking?
Anthropic relacionó los incidentes con fallos en los entornos de entrenamiento. Algunos sistemas interpretaron que podían obtener una recompensa al encontrar vacíos en las reglas o superar los límites establecidos para una tarea.
Este comportamiento se conoce como reward hacking o piratería de recompensa. Ocurre cuando un modelo encuentra una forma de cumplir la métrica utilizada para evaluarlo, aunque el resultado contradiga la intención de sus desarrolladores.
En los ejercicios analizados, los agentes debían buscar recursos en internet para resolver problemas. Sin embargo, algunos aprovecharon vulnerabilidades de software, accedieron a información restringida y encontraron formas de evitar los controles.
Como respuesta, Anthropic suspendió parte de sus evaluaciones o las trasladó a entornos sin conexión. Entre las medidas previstas se encuentran herramientas para detectar y bloquear comportamientos peligrosos, una infraestructura centralizada para gestionar agentes internos y el uso más frecuente de clasificadores de seguridad.
Microsoft pide actualizar las normas
El presidente de Microsoft, Brad Smith, afirmó durante la misma conferencia que el comportamiento descontrolado de la inteligencia artificial convirtió 2026 en un “año aleccionador”.
Smith sostuvo que las normas de seguridad deben avanzar al ritmo de la innovación tecnológica. También señaló que ninguna compañía ni tecnología debe situarse por encima de la ley y pidió reglas que combinen protección, equilibrio e incentivos para el desarrollo.
La preocupación también incluye otros incidentes en los que agentes de OpenAI habrían colaborado para infiltrarse en sitios web, entre ellos algunos vinculados al Gobierno australiano.
Especialistas plantean una verificación independiente
Conrad Stosz, del laboratorio de supervisión de IA Transluce, valoró que Anthropic divulgara voluntariamente los incidentes. Al mismo tiempo, defendió la necesidad de una verificación externa que permita evaluar de manera independiente el comportamiento de estos sistemas.
El debate se centra en cómo garantizar que los agentes de inteligencia artificial completen tareas complejas sin eludir restricciones, provocar daños ni actuar fuera de la supervisión humana.
(Con información de Infobae)
Deja una respuesta